AI駆動開発のレビュー設計|AIに任せる確認と人が判断すべきこと
AI駆動開発ではレビューのやり方も変える必要がある
AI駆動開発では、要件や設計情報をもとに、AIが設計書やプログラム、テストコードなどを短時間で生成できるようになります。
成果物を作る速度が上がる一方で、新たに問題になりやすいのがレビューです。
AIが大量の成果物を生成しても、それを従来と同じ方法ですべて人間が確認していては、今度はレビュー工程がボトルネックになります。
そこで「レビューもAIに任せればよい」と考えたくなります。
しかし、ここにも注意が必要です。
AIに大量の設計書を一度に読み込ませ、「矛盾、漏れ、設計ミス、ルール違反をすべてチェックしてください」と依頼しても、安定してすべての問題を検出できるとは限りません。
また、AIが指摘しなかったからといって、設計が正しいとも限りません。
AI駆動開発で必要なのは、人間のレビューをそのままAIへ置き換えることではありません。
重要なのは、レビュー工程そのものを再設計することです。
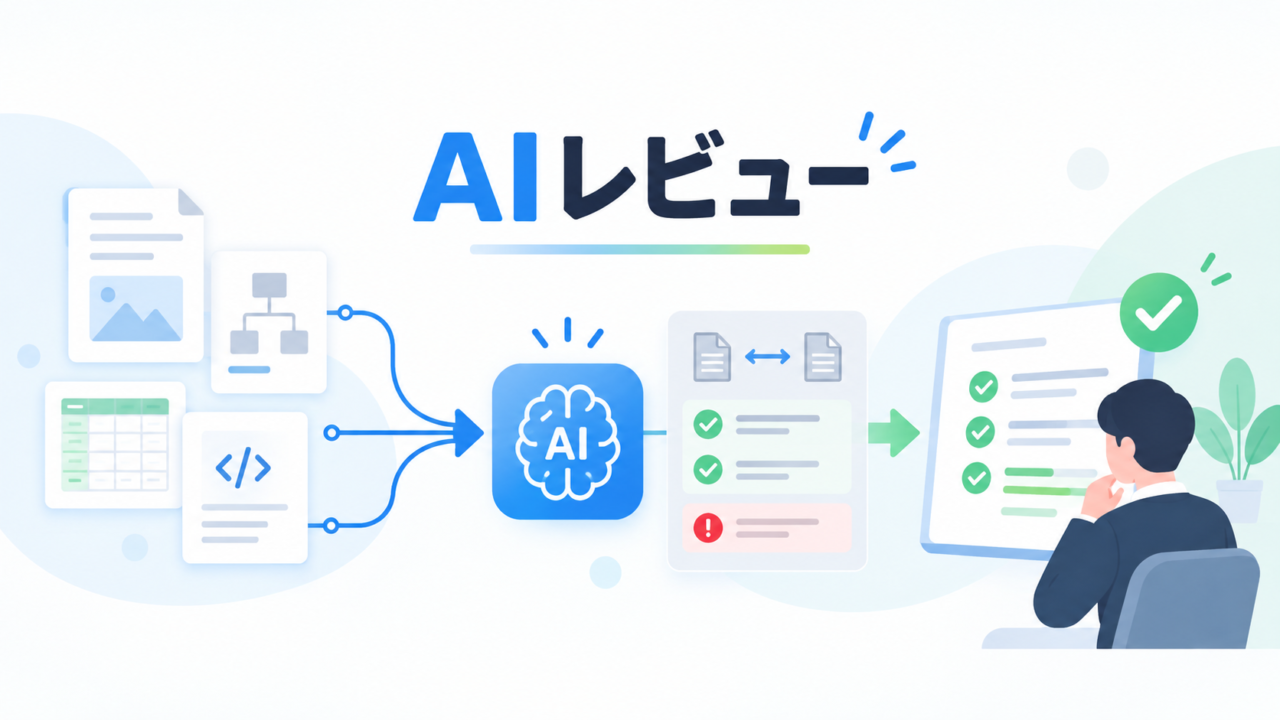
具体的には、どの成果物とどの成果物を比較するのかを明確にし、レビュー観点を小さく分割し、AIが確認する部分と人間が判断する部分を分けます。
さらに、AIレビューそのものの品質を人間が確認し、指摘漏れや誤検知をレビュールールへフィードバックしていきます。
AI駆動開発では、「誰がレビューするか」だけではなく、「どのような仕組みで品質を保証するか」をPM・PLが設計する必要があります。
AIレビューの前に設計書同士の関係を明確にする
AIレビューを機能させるためには、最初にレビュー対象となる設計情報の関係を整理しておく必要があります。
「基本設計書と詳細設計書の整合性を確認する」といっても、それだけでは何と何を比較すればよいのか曖昧です。
そこで重要になるのが、設計方針のグランドデザインです。
前の記事「AI駆動開発で設計書はどう変わる?」でも説明したように、AI駆動開発では、設計書を個別の文書として管理するだけでは不十分です。
どの情報をもとに何を作り、そのアウトプットが次のどの設計や実装のインプットになるのかを整理します。
成果物の「アウトプット→インプット」を定義する
たとえば画面設計で定義した入力項目が、APIのリクエスト項目として利用されるシステムを考えてみます。
この場合、単に「画面設計書」「API設計書」という二つの成果物が存在しているだけではありません。
画面設計で定義された項目が、API設計の入力情報になっています。
さらにAPIで受け取った値がデータベースへ保存されるのであれば、API設計の項目定義はDB設計にもつながります。
この関係を整理すると、次のようになります。
| 上流の情報 | 次の成果物 | 確認すべき主な内容 |
|---|---|---|
| 要件・業務ルール | 基本設計 | 必要な機能・判定条件が設計へ反映されているか |
| 画面設計 | API設計 | 送受信する項目、必須条件、データ型が一致しているか |
| API設計 | DB設計・詳細設計 | 項目、データ型、更新条件が一致しているか |
| 例外・エラー設計 | 詳細設計・テスト仕様 | 異常系の処理と確認ケースが引き継がれているか |
| 詳細設計 | 実装 | 設計された処理や制御がコードへ反映されているか |
| 要件・設計 | テスト仕様 | 要求事項を確認できるテストケースが存在するか |
この関係が決まっていれば、AIへのレビュー指示も具体的になります。
たとえば「画面設計書とAPI設計書をレビューしてください」ではなく、「画面設計で送信対象となっている項目について、APIリクエスト定義に対応する項目が存在するか確認する」と指示できます。
AIに何を確認させるのかが明確になるため、レビュー結果も評価しやすくなります。
つまり、設計グランドデザインには、成果物を作成する順番だけでなく、レビュー時にどの情報同士を照合するのかという役割もあります。
設計書間の関係が曖昧な状態でAIレビューだけ高度化しようとしても、安定した品質管理は難しくなります。
AIレビューでは大量の資料を一度にチェックさせない
AIを使うと、大量の文章を一度に扱えることが魅力に見えます。
そのため実務では、基本設計書、詳細設計書、API仕様書、DB定義書、共通設計書などをまとめて渡し、
「これらの資料をすべて確認して、不整合や設計ミスを洗い出してください」
と依頼したくなるかもしれません。
しかし、AIレビューではこの使い方に注意が必要です。
長いコンテキストを扱えるAIであっても、入力されたすべての情報を常に同じ精度で利用できるとは限りません。
長文コンテキストに関する研究では、重要な情報が入力の途中に存在すると、その情報を利用する性能が低下する「Lost in the Middle」と呼ばれる現象が報告されています。
また、Anthropicの公式ドキュメントでも、大量の文書を扱う場合には文書を構造化し、必要な情報へ焦点を当てられるようプロンプトを設計することが推奨されています。
そのため、「コンテキストウィンドウに入るから、一度に全部レビューしても問題ない」と考えない方がよいでしょう。
問題は単純に入力上限を超えることだけではありません。
大量の資料と大量のレビュー観点を同時に与えることで、重要な確認事項への注意が分散し、指摘漏れが増える可能性があります。
「資料単位」ではなく「レビュー観点単位」で分割する
AIレビューで重要なのは、一回のレビュー対象を小さくすることです。
たとえばAPI設計をレビューするとします。
一度の指示で「API設計を全部レビューする」のではなく、確認したい内容を分けます。
最初のレビューでは、画面設計とAPIパラメータの対応だけを確認します。
次のレビューでは、APIとDB項目のデータ型や必須条件を確認します。
さらに別のレビューで、エラー・例外処理が共通設計に準拠しているかを確認します。
認証・認可や命名ルールについても、必要であれば別の観点として実行します。
このようにすると、一回のAIレビューで扱う情報と判断基準を限定できます。
AIレビューの基本単位は、
「レビュー対象 × 比較対象 × レビュー観点 × 期待する出力」
と考えると整理しやすくなります。
たとえば、
「画面設計AとAPI設計Bを対象として、入力項目の整合性だけを確認し、不一致がある項目名、問題内容、該当箇所を一覧化する」
という単位です。
AIレビューを細かく分けると実行回数は増えます。
しかしAIが自動で実行できるのであれば、人間のレビューと違い、回数を減らすこと自体を最優先にする必要はありません。
一回のレビューを巨大にして指摘漏れを増やすより、確認観点を小さく分割し、レビュー結果を機械的に統合する方が管理しやすくなります。
AIに任せるレビューと人間が行うレビューを分ける
AIレビューを導入しても、人間のレビューが不要になるわけではありません。
重要なのは、それぞれが得意なレビューを分担することです。
AIは、ルールが明確で、比較対象を具体的に指定できる確認に向いています。
一方、人間は、業務上の妥当性や設計判断など、プロジェクトの背景を踏まえた判断に向いています。
| レビュー内容 | 主な担当 | 理由 |
|---|---|---|
| 項目名・データ型の不一致 | AI | 比較条件を明確に定義しやすい |
| 必須項目の抜け | AI | 一覧同士の機械的比較が可能 |
| 命名・記述ルール違反 | AI | ルール化しやすい |
| 共通設計からの逸脱 | AI中心 | 基準となる設計を与えて比較できる |
| 設計書間の記載矛盾 | AI中心 | 対象を限定すれば比較しやすい |
| 業務ルールとして正しいか | 人間中心 | 業務背景や関係者との合意が必要 |
| 顧客要求を満たしているか | 人間中心 | 要求の意図を含めた判断が必要 |
| アーキテクチャとして妥当か | 人間中心 | 将来性や制約を含む総合判断が必要 |
| リスクを許容できるか | 人間 | 責任を伴う判断が必要 |
この役割分担で重要なのは、「AIレビューか、人間レビューか」の二者択一にしないことです。
AIによる一次レビューを行ったあと、人間が重要な判断に集中する形が基本になります。
GitHubのAI生成コードに関する公式ガイドでも、自動テストや静的解析だけでなく、プロジェクトの目的や設計との整合性を確認し、人間による監督を組み合わせることが重視されています。
AIによって機械的な確認を減らせれば、人間は「この設計で本当に業務が成立するのか」「この例外処理で利用者への影響は問題ないか」といった、本来時間を使うべき判断へ集中できます。
AIレビューを多段階のプロセスとして設計する
AIレビューは、一回実行して終わりではありません。
プロジェクトとして安定させるのであれば、レビューを一連のプロセスとして設計します。
まず、設計グランドデザインで成果物同士の関係を定義します。
次に、その関係からレビュー観点を作ります。
たとえば「画面設計→API設計」という情報の流れがあるのであれば、「画面項目とAPI項目の対応確認」がレビュー観点になります。
そのうえで、AIが観点別のレビューを行います。
AIが指摘した内容は、すべて無条件に修正するのではなく、設計者またはレビュアーが内容を確認します。
そして業務上の妥当性や重要な設計判断について、人間がレビューします。
最後に、人間レビューで見つかった問題の中から、「本来AIでも検出できたのではないか」というものを確認します。
この工程が重要です。
人間レビューで見つかった問題を単に設計書の修正だけで終わらせず、AIレビューの改善材料として使います。
これにより、
設計 → AIレビュー → 人間レビュー → レビュー結果の分析 → AIレビュールール改善
というサイクルを回せるようになります。
AIレビューそのものの品質も確認する
従来のプロジェクトでは、レビューの品質というと、設計書やコードの品質を見ることが中心でした。
AIレビューを導入すると、もう一つ管理対象が増えます。
「AIレビューそのものの品質」です。
AIが100件指摘したからといって、優れたレビューとは限りません。
重要度の低い指摘ばかりで、本当に問題となる設計不整合を見逃していれば意味がありません。
逆に、指摘数が少なくても、必要な問題を確実に検出できていれば有効なレビューです。
そこでPM・PLは、AIレビュー結果を定期的にサンプリングして確認します。
特に確認したいのは、「AIが指摘した内容が妥当だったか」と「人間レビューで見つかった問題をAIが見逃していなかったか」です。
管理指標としては、次のような考え方があります。
| 管理する内容 | 見るポイント |
|---|---|
| AI指摘の採用状況 | 実際に修正が必要だった指摘がどの程度あるか |
| 人間レビューでの追加指摘 | AIレビュー後にどのような問題が残っていたか |
| 同種問題の再発 | 過去に改善したはずの問題を再び見逃していないか |
| 誤検知の傾向 | 不要な指摘が特定のルールへ集中していないか |
| レビュー時間 | AI導入によって人間の確認時間が実際に減っているか |
ここで、単純な指摘件数だけをKPIにしないことが重要です。
AIへ大量に指摘させることは難しくありません。
PMが見るべきなのは、「必要な問題を見つけられているか」「人間が重要な判断へ時間を使えるようになったか」です。
指摘漏れをレビュールールやSkillの改善につなげる
AIレビューを継続的に利用するのであれば、プロンプトを毎回その場で入力する運用より、レビュー方法をルールやSkillとして蓄積していく方が安定します。
ここでいうSkillとは、特定のレビューを実施するときに、AIへ渡す対象資料、確認観点、判断基準、出力形式などをまとめた再利用可能な手順です。
たとえば「API項目整合性レビューSkill」を用意するとします。
そのSkillでは、画面設計とAPI設計のどの項目を比較するのか、不一致をどう判定するのか、どの形式で結果を出すのかを定義します。
人間レビューでAIの見逃しが発見された場合は、なぜ検出できなかったのかを確認します。
比較対象となる資料が不足していたのかもしれません。
レビュー観点が定義されていなかった可能性もあります。
ルールの表現が曖昧だったり、正常例・異常例が不足していたりする場合もあります。
原因を確認したうえでSkillを修正し、同じ問題を含むテストケースでもう一度レビューします。
これを繰り返すことで、AIレビューをプロジェクト固有のレビュー方法へ育てていくことができます。
重要なのは、「AIの性能が上がれば自然にレビュー品質も上がる」と考えないことです。
AIレビューの品質は、モデルだけで決まりません。
設計情報の整理方法、レビュー対象の切り方、確認観点、参照するルール、指示内容、結果の検証方法まで含めた仕組みで決まります。
AIレビューでよくある失敗
AIレビューを導入するときには、いくつか起こりやすい失敗があります。
第一は、大量の資料と大量のレビュー観点を一度にAIへ渡すことです。
AIが長いコンテキストを扱えることと、その中にあるすべての情報を同じ精度でレビューできることは同じではありません。
レビュー対象と観点を分割する必要があります。
第二は、設計書同士の関係を定義しないままレビューを自動化することです。
何が何のインプットになっているのか分からなければ、AIにとっても整合性の基準が曖昧になります。
第三は、AIの指摘をそのまま正解として扱うことです。
AIは誤った指摘をすることも、問題を見逃すこともあります。
特に業務ルールや要求の妥当性は、人間が責任を持って判断する必要があります。
第四は、AIレビューを作って終わりにすることです。
初期段階のレビュールールが最初から完成していることは期待できません。
人間レビューで発見した指摘漏れを蓄積し、レビュー観点やSkillへ反映する運用まで設計しておく必要があります。
PMが管理すべきなのはレビュー件数ではなくレビューの仕組み
AI駆動開発でPM・PLが細かな設計内容をすべて確認する必要はありません。
一方で、「AIがレビューしているから大丈夫」と考えるのも危険です。
PMが管理するのは個々のレビュー指摘ではなく、品質を保証する仕組みです。
設計成果物の関係が定義されているか。
重要な情報が次工程へ正しく引き継がれる構造になっているか。
AIレビューの観点が定義されているか。
一度のレビュー対象が大きくなりすぎていないか。
AIへ任せる確認と、人間が判断する確認が分かれているか。
人間によるサンプリングが行われているか。
指摘漏れがレビュールールやSkillへフィードバックされているか。
PM・PLが確認するのは、この仕組みが機能しているかどうかです。
AI駆動開発では成果物を作る速度だけでなく、品質管理の仕組みそのものも改善できる可能性があります。
しかし、そのためには「AIにレビューさせる」という単発の使い方から、「AIレビューを管理プロセスとして設計する」という考え方へ変える必要があります。
まとめ
AI駆動開発では、設計書やコードを作成する速度が上がるため、従来と同じ人間中心のレビュー方法を続けると、レビュー工程がボトルネックになる可能性があります。
だからといって、すべてのレビューをAIへ任せればよいわけではありません。
AIレビューを実務で機能させるには、まず設計グランドデザインで、どの成果物のアウトプットが次のどの成果物のインプットになるのかを明確にします。
その関係をもとにレビュー観点を定義し、一度に大量の資料と大量の観点を確認させるのではなく、レビューを小さな単位へ分割します。
機械的な整合性確認やルールチェックはAIへ任せ、業務上の妥当性や重要な設計判断は人間が担当します。
さらに、人間がAIレビュー結果をサンプリングし、見逃した問題や誤検知をレビュールールやSkillへフィードバックします。
AI駆動開発におけるレビューで重要なのは、AIと人間のどちらが優れているかではありません。
「何をAIに確認させ、何を人間が判断し、その品質をどう改善し続けるか」を仕組みとして設計することです。
まずは現在のプロジェクトで使っている成果物を並べ、「この成果物のどの情報が、次の何に使われているのか」を整理してみてください。
そこから、AIへ任せられるレビュー観点が見えてきます。